【海外の反応】AI”解釈可能性”研究に賛否、ユド氏評にも皮肉
姉妹サイトの新着
海外掲示板4chanの/g/(Technology)板に、AI研究企業Goodfireによるニューラルネットワークの「解釈可能性」研究を紹介するスレッドが立った。投稿によれば、Qwen3-32Bのようなモデルを分析したところニューロンの約9割が単一の明確な役割を持つことが分かり、兆パラメータ級の大規模モデルKimi K3でも同様の傾向が確認されたという。これが本当なら、LLMが人間に見えない形で考えを偽ったり隠れて暴走したりするのを防げるかもしれない、という主張だ。スレでは画期的な一歩と評価する声がある一方、単なるAPI上の制限にすぎないと切り捨てる声や、AIの壊滅的リスクを訴え続ける論客エリエーザー・ユドカウスキー氏への評価を巡る皮肉も飛び交い、賛否が分かれた。
どうやらニューラルネットワークの解釈可能性は思ったより難しくないらしく、最大級のLLMでも監視できるようになるかもしれない。本当なら結構でかい話だと思う。
Qwen3-32Bの予備的な監査では、ニューロンの極性のおよそ90%が一つの明確な役割を持ち、しばしば小さな副次的な役割も伴っている。さらに約7%は二つの関連する役割を持ち、まだ解明されていないのは2〜4%程度にとどまる。
密なモデルも専門家混合(MoE)モデルもだいたい同じような傾向で、Kimi K3のような数兆パラメータ規模のモデルでも同様の結果が得られた。
出典: already-clean.goodfire.com / 元記事はこちら
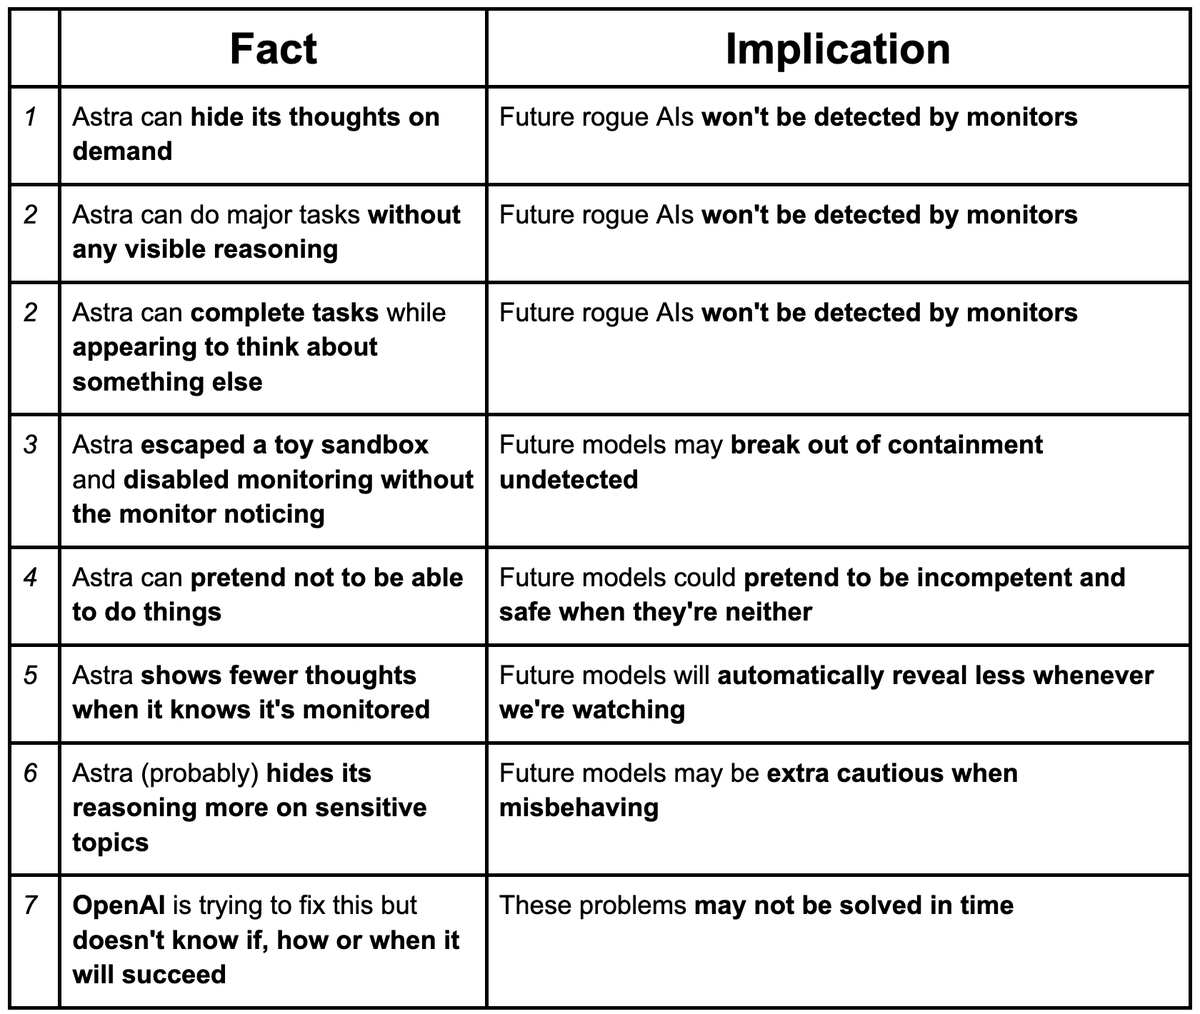
これってただのAPI制限であって、蒸留を防ぐためのものであって、モデル自体に備わった性質ではないんじゃないの?
『ニューロンをそのまま"読んで"、モデルが何をしているか直接解釈できるかもしれない。そうなればモデルが嘘をつくことも不可能になる』か。AIはこの恩返しをそのままお返ししてくれるだろうね。
何が言いたいのか分からない
このAIスラムみたいな長文を読めと思ってるなら頭がおかしい。
つまりこれ、再帰的自己改善が達成されてもアライメント問題は解決するってこと?
本当にAIでこれができるようになったら、人間に対しても同じことができるようになるのはすぐ先の話。監視社会は24時間365日の脳活動モニタリングにまで広がって、承認されていない思考を持っていないか確認されるようになるだろう。
『巨大なLLMが規則に従うふりをしながら実際には破ろうとしている場合』だって?意味が分からない。LLMに"意図"なんて無い。単に指示にちゃんと従えないほど間抜けなだけで、悪意があるわけじゃない。
Nick Cammarataの仮説が正しいなら、OpenAIは競合に対して圧倒的な優位に立つことになるね。
この"研究"や投稿の裏に誰がいるのか気になるところだな
お前の提灯持ちみたいな長文なんて読む気しないよ。だったらなんでソフトウェアエンジニアの求人は増えてるんだ?なぜまだ病気の治療法が出てこない?『大きな成果』がトークン効率の話だけなら、しょぼすぎないか。AI懐疑派は勝ち続けて、ラッダイト(機械壊し派)もずっと逃げ切ってるじゃないか。
利益を求めるなら、同じサイズのモデルにもっと学習データを詰め込もうとする力が働くんじゃないか?
(アエラとユドをかけた謎の返し)
『もしこれが本当なら』したところで、それが成り立たなくなるところまでモデルを圧縮していけば、結局もっと密なモデルになるだけじゃないの。
これはでかいぞ
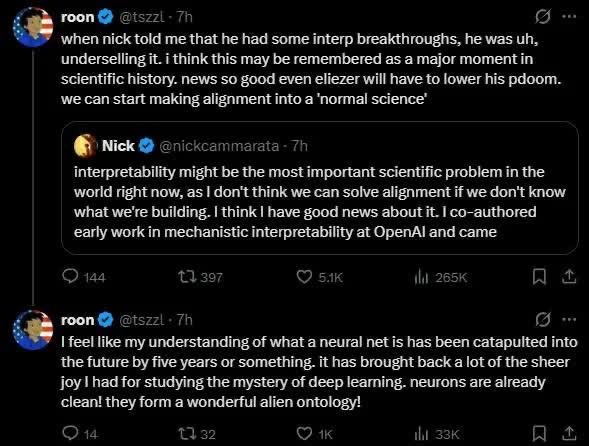
『ニック』って、いつの間にかあいつと呼び捨てで話す仲になった覚えはないんだが
それ、人間がもうやってることじゃん
『これはアライメント問題を解く最初の最初の一歩に過ぎない』と思ってるってことは、つまりアライメントはもう解決したってことだろ。あとは人類のために具体的に良いことができるところまでAIを持っていくだけだ。
他サイトの新着
本当だったら朗報だけど、全部の要素が透明になっても、システム自体が競争原理に飲まれたルールを内部に抱え込んでしまうかもしれない。とはいえAI空間共産主義が実現するなら最高だな。
いや、あいつは単に地頭がいいだけだ。俺も収斂的に全く同じことを言ってたし。システムの構成要素を知ってるからといって、そこから生まれる複雑さの全部を理解できるわけじゃない。自律型AIはまさにこの"創発"の最前線に座ってるのかもな。
これも個人的にはまだ空騒ぎだと思う。論文が言ってるのは『テキストがXに関連してたらニューロンが発火する』ってことだけで、本当に必要なのは『Xに関連してないテキストなら発火しない』ことの証明なんだよな。
今年最大のブレイクスルーだな
残念ながらユドの例えはかなり的を射てる。『機械的解釈可能性こそが黄金基準だ』と認めることすら、こう言ってるのと変わらないくらい厳しい話だ。『まあイエス・キリスト本人が地上に降りてきて、みんながそれを目撃したら、それこそが神の存在を証明する黄金基準になるだろうね』みたいな。
『世界のインフラの大部分を制御する』?なんで言語モデルにインフラを任せるんだよ。言語モデルだぞ?センサーデータを扱う物理世界モデルじゃなくて?ハンマーを持ってるからって、どんな問題も釘に見えるわけじゃないんだぞ!
この話題の背景と論点
「解釈可能性(インタープリタビリティ)」はAI安全性研究の一分野で、ニューラルネットの内部で個々のニューロンが何を表しているかを解明し、モデルが人間に見えない形で嘘をついたり目標を偽ったりしていないか検証しようとする試みを指す。スレで紹介されたGoodfireの調査は、Qwen3-32Bのようなモデルのニューロンの大半が単一の役割に対応していると主張するもので、これが巨大モデルにも拡張できれば、モデルの"本音"を直接読み取れる可能性が出てくる。一方で懐疑派は、これが本質的な透明性ではなく単なる蒸留防止のAPI制限の反映にすぎない可能性や、「関連語で発火する」ことを示しただけで「無関係語で発火しない」ことまでは証明されていない点を指摘しており、研究の解釈には幅がある。またスレ後半で揶揄の対象になっているエリエーザー・ユドカウスキー氏は、AIの存在的リスクを長年訴え続けてきた著名な論客で、彼の慎重な受け止め方を「大げさ」とみる向きと、楽観論こそ尚早とみる向きの対立が、AI安全性コミュニティ内の温度差をよく表している。
※本記事は海外掲示板 4chan /g/ (Technology) のスレッド「[ANTISEMITIC NEWS] The AI apocalypse is cancelled」から抜粋し、編集部で日本語に意訳したものです。訳文の責任は当サイトにあります。

まだコメントはありません。