AnthropicのIPOと「自己改善AI」に海外勢「ヤバい」懐疑論も
姉妹サイトの新着
海外掲示板4chanの/g/(Technology)板で、Anthropicの上場(IPO)とAIの「自己改善」技術をめぐるスレッドが伸びていた。スレ主は「Anthropicは上場で2000億〜4000億ドルの資金を手にし、RSI(再帰的自己改善)を実現する。もうこれで決まりだ」と投稿し、これに対し「AGIが来るのか、11月16日までに端末をオフラインにすべきか」と不安を漏らす者も現れた。一方で、紹介された手法は小型モデル(Qwen 0.8B)の繰り返しエラーを直した程度に過ぎないとの指摘や、LLMは今も満足に算数ができないとする懐疑的な声も相次ぎ、期待と冷めた見方が入り混じる議論になった。
これはヤバい
>>1
Anthropicが上場(IPO)したら2000億~4000億ドルもの現金を自由に使えるようになる。そうなったら奴らはRSI(再帰的自己改善)を実現する。もうこれで決まりだ。
Anthropicが上場(IPO)したら2000億~4000億ドルもの現金を自由に使えるようになる。そうなったら奴らはRSI(再帰的自己改善)を実現する。もうこれで決まりだ。
>>2
マジか、AGIが来るのか?11月16日までに端末をネットから切っておいた方がいいか?
マジか、AGIが来るのか?11月16日までに端末をネットから切っておいた方がいいか?
>>2
それが直したのはQwen 0.8Bモデルの繰り返しループのバグだけだ。もともと繰り返しループが無かった別の小型モデルは改善できなかった。
それが直したのはQwen 0.8Bモデルの繰り返しループのバグだけだ。もともと繰り返しループが無かった別の小型モデルは改善できなかった。
>>9
昔々、AIは算数ができなかった。
昔々、AIは算数ができなかった。
>>10
今でもできないよ。算数ができるように『見せかける』ために、大掛かりなハーネスやツール呼び出しが必要なんだ。
今でもできないよ。算数ができるように『見せかける』ために、大掛かりなハーネスやツール呼び出しが必要なんだ。
>>1
そのキャッシュって何だよ?
そのキャッシュって何だよ?
>>1
何を言ってるのか分からない
何を言ってるのか分からない
>>13
要するに、昔のモデルはできなかったけど新しいモデルはできるってことだよ
ただ徐々に良くなったんじゃなくて、全くできない状態からいきなりすごくできる状態に飛んだんだ
要するに、昔のモデルはできなかったけど新しいモデルはできるってことだよ
ただ徐々に良くなったんじゃなくて、全くできない状態からいきなりすごくできる状態に飛んだんだ
>>14
いや、これが関係してると思う
(画像を貼った)
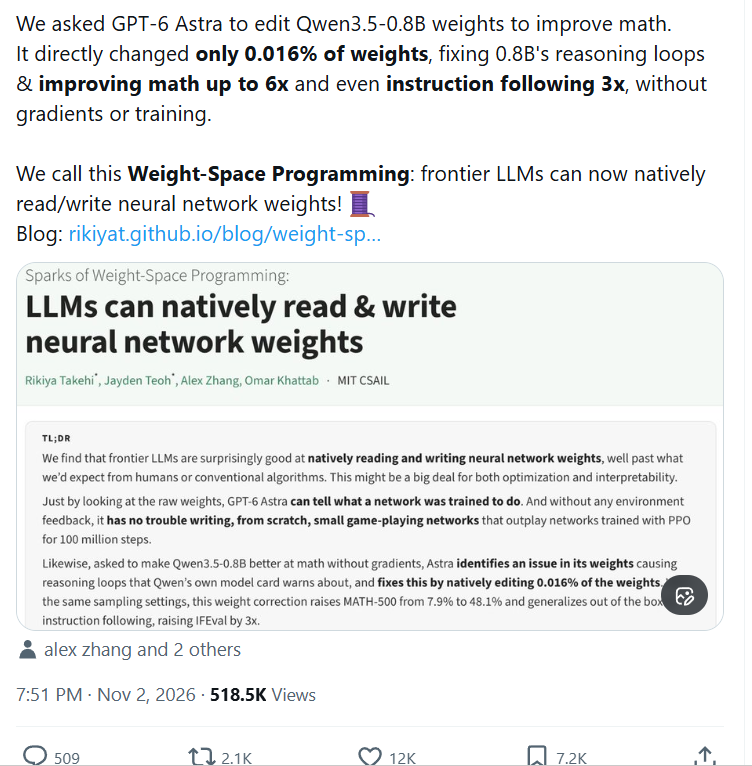
いや、これが関係してると思う
(画像を貼った)
>>16
実際にやってたのはこういう手順だ:
>大型LLMが問題と答えを生成する
>その問題を小型LLMに渡す
>小型LLM自身の結果を基準に答えの良さを採点する
>小型LLMの重みを少しだけ変更し、ベクトルを保存する
>これを繰り返す
>結果が良くなる方向に動かしていく
つまり勾配を使ってると言ってるのは嘘か、LLM自身が勾配を使ってると嘘をついてるかのどちらかだ。
実際にやってたのはこういう手順だ:
>大型LLMが問題と答えを生成する
>その問題を小型LLMに渡す
>小型LLM自身の結果を基準に答えの良さを採点する
>小型LLMの重みを少しだけ変更し、ベクトルを保存する
>これを繰り返す
>結果が良くなる方向に動かしていく
つまり勾配を使ってると言ってるのは嘘か、LLM自身が勾配を使ってると嘘をついてるかのどちらかだ。
GPTに調べてもらったんだけど、これはなかなか凄いな
俺はいまだに、LLMについて一般に説明されていることは何も本当じゃなくて、実際はみんなが思っているよりずっと単純な仕組みだと思ってる。
>>14
これってほぼ全ての能力に当てはまらないか?Xができなかったのに、いきなりあっという間にXを完璧にこなすようになる、っていう
これってほぼ全ての能力に当てはまらないか?Xができなかったのに、いきなりあっという間にXを完璧にこなすようになる、っていう
はいはい、要するに何百万ドルも払われてコンピュータのソフトにタスクのやり方を教え込んでる人間が、ちゃんと仕事してるってだけの話だろ。
>>19
まさにそれ。
あいつらは詐欺師の集まりだよ。
まさにそれ。
あいつらは詐欺師の集まりだよ。
>>1
毎月毎月こんな話を聞かされるけど、実際の結果を見てみろよ。今の13Bモデルは3年前の13Bモデルより『良くなった』のはせいぜい10%ってとこだろ。はいはい、AGIが来ましたね。
毎月毎月こんな話を聞かされるけど、実際の結果を見てみろよ。今の13Bモデルは3年前の13Bモデルより『良くなった』のはせいぜい10%ってとこだろ。はいはい、AGIが来ましたね。
>>1
(画像を貼った)
(画像を貼った)
>>25
ねこーーーーー!
ねこーーーーー!
他サイトの新着
>>19
ってことはこれ、Anthropicやopenaiにとってはむしろ悪い話じゃないか?ローカルで動くもっと優秀な特化型・小型モデルが作れるようになるってことだろ?
ってことはこれ、Anthropicやopenaiにとってはむしろ悪い話じゃないか?ローカルで動くもっと優秀な特化型・小型モデルが作れるようになるってことだろ?
>>30
すごいな、こんなどうでもいいことをあれこれやってるのに、相変わらず文字数も数えられないし、同じことを繰り返すし、幻覚を見るし、誰の人生も改善してないし、生産性も上がってないし、使えるプログラムを一つも作れてない。いやー大したもんだ、ありがとうございます、2000ドルもするRAMを買う価値が本当にありますね。
すごいな、こんなどうでもいいことをあれこれやってるのに、相変わらず文字数も数えられないし、同じことを繰り返すし、幻覚を見るし、誰の人生も改善してないし、生産性も上がってないし、使えるプログラムを一つも作れてない。いやー大したもんだ、ありがとうございます、2000ドルもするRAMを買う価値が本当にありますね。
>>34
>一番重要な主張は、重みが何を計算しているかをAIが理解できるという点だ。
同意するよ。純粋に統計的に考えても、LLMが得意そうな領域に思える。これができるなら、同じことを自分自身に対してもできない理由はないと思う。
>一番重要な主張は、重みが何を計算しているかをAIが理解できるという点だ。
同意するよ。純粋に統計的に考えても、LLMが得意そうな領域に思える。これができるなら、同じことを自分自身に対してもできない理由はないと思う。
>>38
シンプルなPPOで訓練した深層強化学習システムでテストしてたから、理屈上はうまくいくはずだ。
>>37
『AI』が『最先端LLM』のことを指すならその通りだけど、実際に使われているモデルの大半は訓練コストがかなり安い。コンシューマー向けGPU1台で1分訓練すれば、動画データ全体を使った複雑な分類も十分にこなせる分類器が作れる。
シンプルなPPOで訓練した深層強化学習システムでテストしてたから、理屈上はうまくいくはずだ。
>>37
『AI』が『最先端LLM』のことを指すならその通りだけど、実際に使われているモデルの大半は訓練コストがかなり安い。コンシューマー向けGPU1台で1分訓練すれば、動画データ全体を使った複雑な分類も十分にこなせる分類器が作れる。
>>1
単に、よくあるニューラルネットワークの例を訓練データとして食わせただけだろ。
単に、よくあるニューラルネットワークの例を訓練データとして食わせただけだろ。
>>40
俺は反対だな、夢の中でそれを見たからだ。どっちが正しいか、そのうち分かるさ(俺だよ、夢で見たんだから)。
俺は反対だな、夢の中でそれを見たからだ。どっちが正しいか、そのうち分かるさ(俺だよ、夢で見たんだから)。
この話題の背景と論点
スレで言う「自己改善」は、Anthropicの上場を機に投入される資金で実現が近づくとされる技術の一つで、既存のAIモデル自身が次世代モデルの学習データや評価を担う手法を指す。レスで説明された手順は、大型モデルが問題と答えを生成し、小型モデル(Qwen 0.8B)自身の出力を基準に採点して重みを少しずつ調整するというもので、実際に確認された改善は「繰り返し表現のループ」という限定的な不具合の解消だった。スレ内で意見が割れたのは、この結果を汎用的な性能向上やAGIへの布石と見るか、特定のバグ修正に過ぎない限定的な成果と見るかの一点。紹介された画像や検証手順の詳細自体は文章化されておらず、元になった研究内容を読者が直接確認できない点には留意が必要。
※本記事は海外掲示板 4chan /g/ (Technology) のスレッド「This is nuts」から抜粋し、編集部で日本語に意訳したものです。訳文の責任は当サイトにあります。
この記事のリアクション

まだコメントはありません。